LMCache
提供 KV 缓存的持久化、分层卸载(GPU→CPU→本地→远程)、跨请求/会话/引擎复用、非前缀 KV 复用(CacheBlend)、PD 分离与 KV 传输、可插拔存储后端(Redis、S3、Mooncake 等)、生产级可观测性(Kubernetes 指标、KV 缓存命中率等)。
一句话商业模式
为LLM 推理开发者、云服务商、AI 基础设施团队解决KV 缓存管理低效,重复预填充导致高延迟和高成本,通过开源 KV 缓存管理层,支持持久化、复用、压缩、跨集群共享提供价值,主要依靠潜在收费方式:企业支持、托管服务、云市场集成(假设)赚钱
商业模式画布
通过 KV 缓存持久化、复用和分层卸载,降低 TTFT、提升吞吐,减少重复计算,支持跨引擎和跨集群共享
评分解析
研究分 77
这是什么
- 是什么
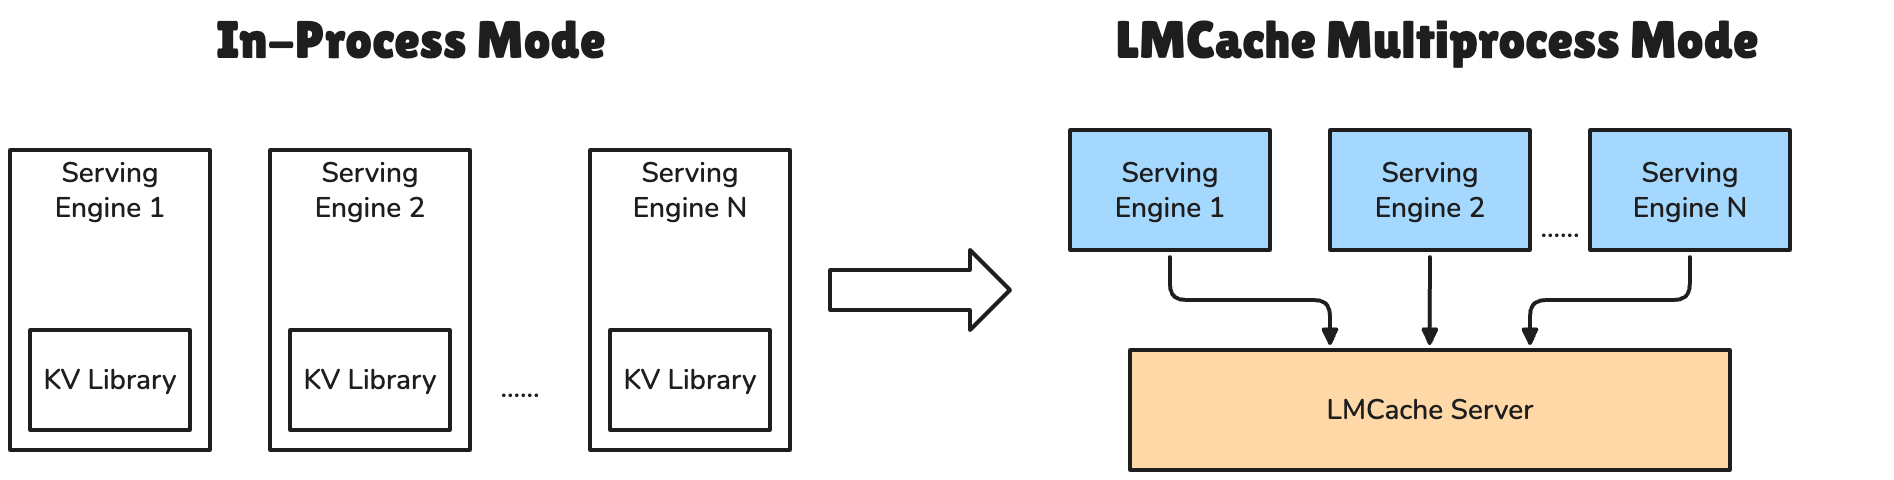
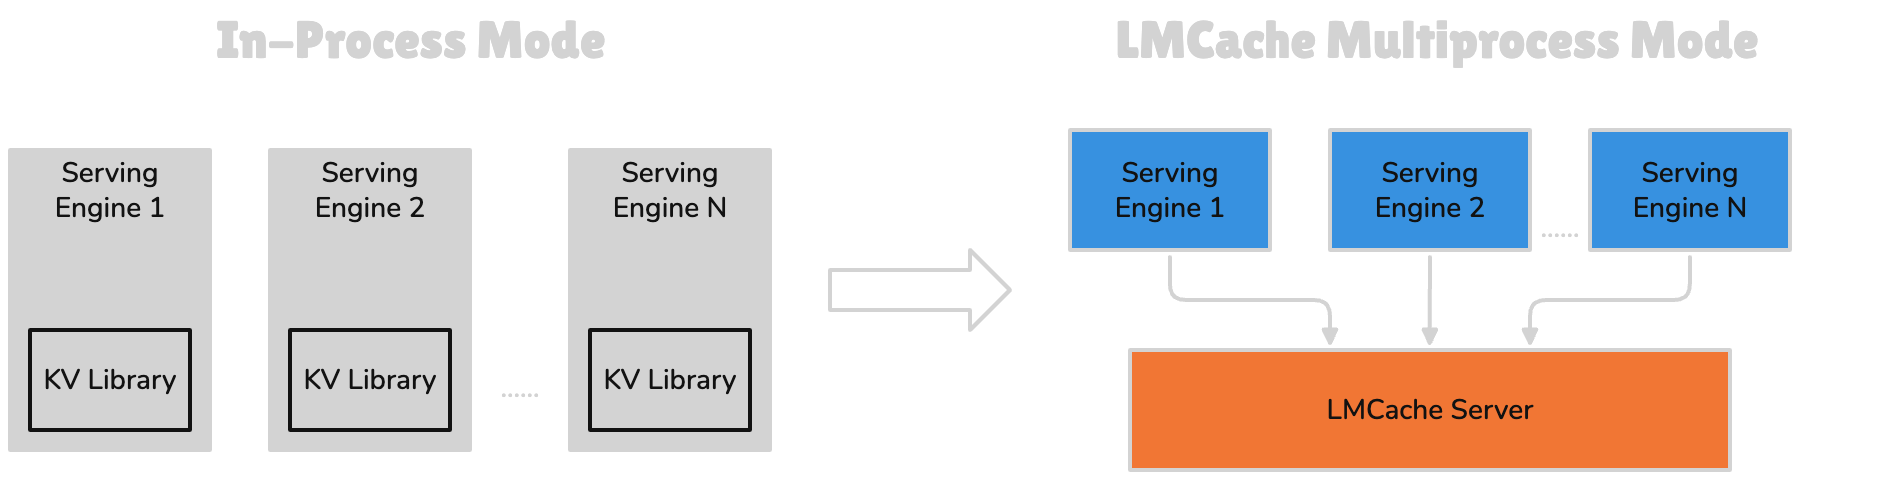
- LMCache 是一个 KV 缓存管理层,用于 LLM 推理,将 KV 缓存转化为可持久化、可复用的 AI 原生内存,支持跨引擎、跨集群的存储与共享。
- 给谁用
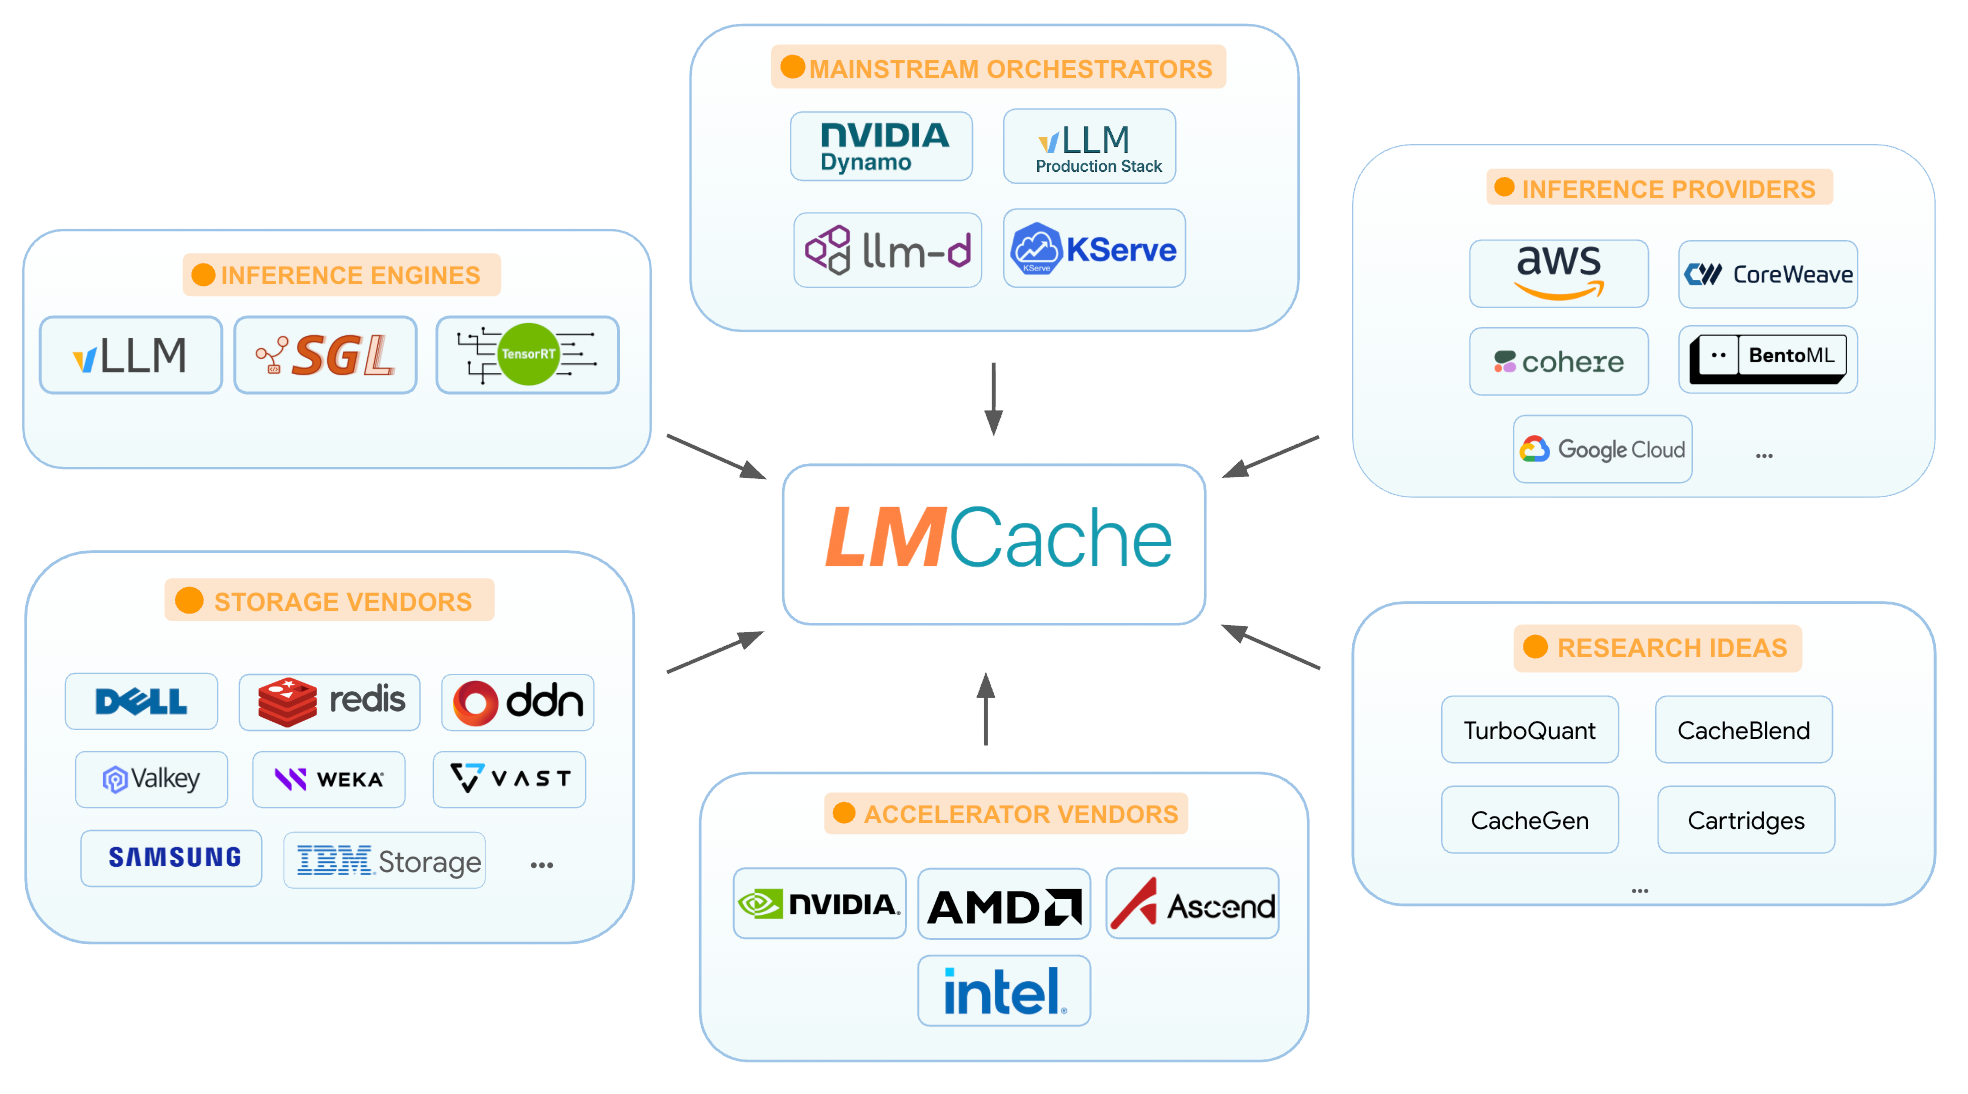
- 面向使用 vLLM 等开源推理引擎的开发者、AI 基础设施团队、云服务商,以及需要优化长上下文、多轮对话、RAG 等场景的 LLM 应用部署者。