Firecrawl

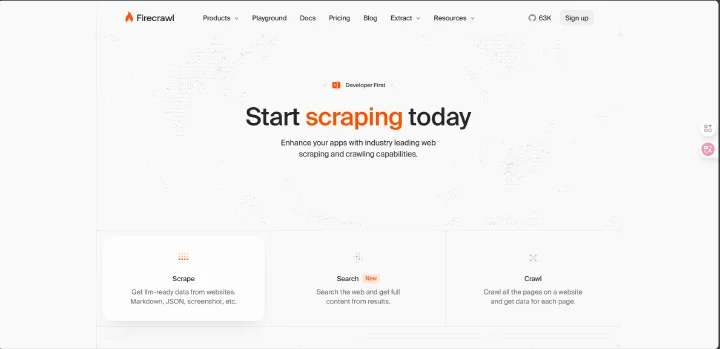
提供搜索、抓取、爬取、网站 URL 映射以及 AI 驱动的结构化数据提取功能,支持处理 JavaScript 密集型页面,并输出多种格式(Markdown、HTML、截图、结构化数据)。

一句话商业模式

为AI 开发者、数据团队解决大规模获取干净、LLM 就绪的网页数据困难,通过Firecrawl API 和开源爬虫工具提供价值,主要依靠API 调用付费(托管服务)赚钱

商业模式画布

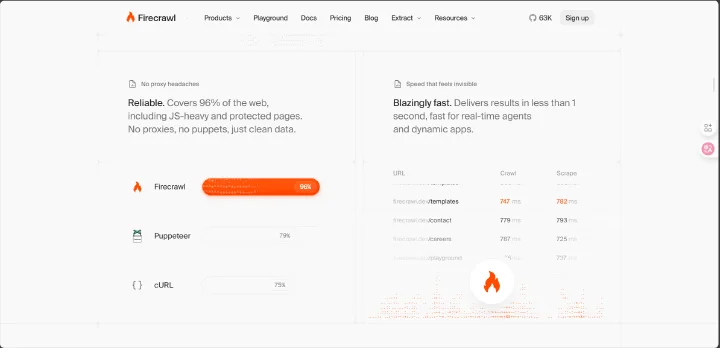
提供行业领先的可靠性(覆盖 96% 网页)、极快速度(P95 延迟 3.4 秒)、LLM 就绪输出,零配置处理代理、速率限制等难题

评分解析

研究分 77

这是什么

是什么
Firecrawl 是一个面向 AI 应用的开源数据爬虫 API,能够将任意 URL 或整个网站抓取并转换为 LLM 可直接使用的干净 Markdown、结构化 JSON 等格式。
给谁用
主要面向需要大规模获取网页数据来训练或增强 AI 模型的开发者、AI 代理构建者以及需要网页数据集成到应用中的团队。
← 返回今日精选
Firecrawl

Firecrawl

提供搜索、抓取、爬取、网站 URL 映射以及 AI 驱动的结构化数据提取功能,支持处理 JavaScript 密集型页面,并输出多种格式(Markdown、HTML、截图、结构化数据)。

77

一句话商业模式

为AI 开发者、数据团队解决大规模获取干净、LLM 就绪的网页数据困难,通过Firecrawl API 和开源爬虫工具提供价值,主要依靠API 调用付费(托管服务)赚钱

开发者工具AI开源爬虫API团队 未知发布 未知最后同步 2026-07-27

产品图

商业模式画布

Business Model Canvas · 9 大模块完整填涂

重要合作Key Partnerships
AI 代理平台(如 Claude Code)、MCP 客户端、云服务提供商
关键业务Key Activities
维护开源核心、优化爬虫引擎、开发新功能(如交互、AI 提取)、社区运营
价值主张Value Propositions
提供行业领先的可靠性(覆盖 96% 网页)、极快速度(P95 延迟 3.4 秒)、LLM 就绪输出,零配置处理代理、速率限制等难题
客户关系Customer Relationships
通过开源社区(GitHub、Discord)、文档、API 支持、社交媒体(X、LinkedIn)维护关系
客户细分Customer Segments
AI 开发者、数据科学家、需要网页数据集成到 AI 应用的团队
核心资源Key Resources
开源代码库、API 基础设施、反爬技术、开发者社区
渠道通路Channels
通过开源社区(GitHub)、开发者口碑、Hacker News 展示、AI 代理集成(MCP)等方式获客
成本结构Cost Structure
服务器和带宽成本、反爬代理成本、研发人力成本、社区运营成本
收入来源Revenue Streams
通过 API 调用次数或订阅计划收费,提供免费层吸引用户,付费层提供更高配额和高级功能
💡 核心痛点:从复杂、JS 密集型网站获取干净、结构化数据困难,现有工具可靠性低、速度慢、配置复杂⚠️ 最大风险:面临来自其他开源爬虫(如 Teracrawl、FastCRW)的竞争,以及用户自建替代方案的趋势;闭源反爬组件可能限制自托管用户

评分解析

痛点清晰度

开发者从复杂网站获取干净数据是明确且普遍的痛点,Firecrawl 直接解决此问题。

置信度 80%
85
付费可能性

API 付费模式在开发者工具中常见,用户有付费意愿(如月费 $190 的案例),但面临开源替代品竞争。

置信度 70%
75
市场与趋势

AI 应用爆发带动对高质量网页数据的需求,市场趋势强劲。

置信度 90%
90
需求信号

GitHub 星标高、社区活跃、Hacker News 讨论多,表明有较强需求信号。

置信度 80%
80
执行可行性

开源项目有社区贡献,但闭源反爬组件和用户反馈的屏蔽问题表明执行上仍有挑战。

置信度 60%
70
中国市场适配

中国有类似需求,但 Firecrawl 的 API 服务可能受网络限制,自托管版本可能更适用,但闭源组件是障碍。

置信度 50%
50

这是什么

是什么
Firecrawl 是一个面向 AI 应用的开源数据爬虫 API,能够将任意 URL 或整个网站抓取并转换为 LLM 可直接使用的干净 Markdown、结构化 JSON 等格式。
给谁用
主要面向需要大规模获取网页数据来训练或增强 AI 模型的开发者、AI 代理构建者以及需要网页数据集成到应用中的团队。
关键能力

  • 搜索:搜索网络并获取完整页面内容
  • 抓取:将任意 URL 转换为 Markdown、HTML、截图或结构化 JSON
  • 爬取:通过单个请求抓取网站的所有 URL
  • 映射:快速发现网站的所有 URL
  • AI 提取:使用 AI 从单页、多页或整个网站中获取结构化数据
  • 交互:抓取页面后通过 AI 提示或代码进行点击、滚动等操作

创业线索

团队
未知 · GitHub 仓库有多个贡献者,但具体团队规模未披露
发布时间
未知 · GitHub 仓库活跃,有持续更新
增长线索
GitHub 星标数较高,社区活跃(Discord、LinkedIn)
能赚多少 / 怎么赚
未知具体收入,但用户提及月费约 $190 · 提供托管 API 服务,有付费计划

公开信息推断,缺数据会标未知;不构成收益承诺。

相关新闻 / 讨论

来源数据

  • 首次采集:2026-07-26
  • 最后同步:2026-07-27
  • 材料更新:2026-07-27
  • 穿透材料体量:约 12,905 字

AI 辅助分析,仅供项目研究参考,不构成投资建议。