EchoMimicV3
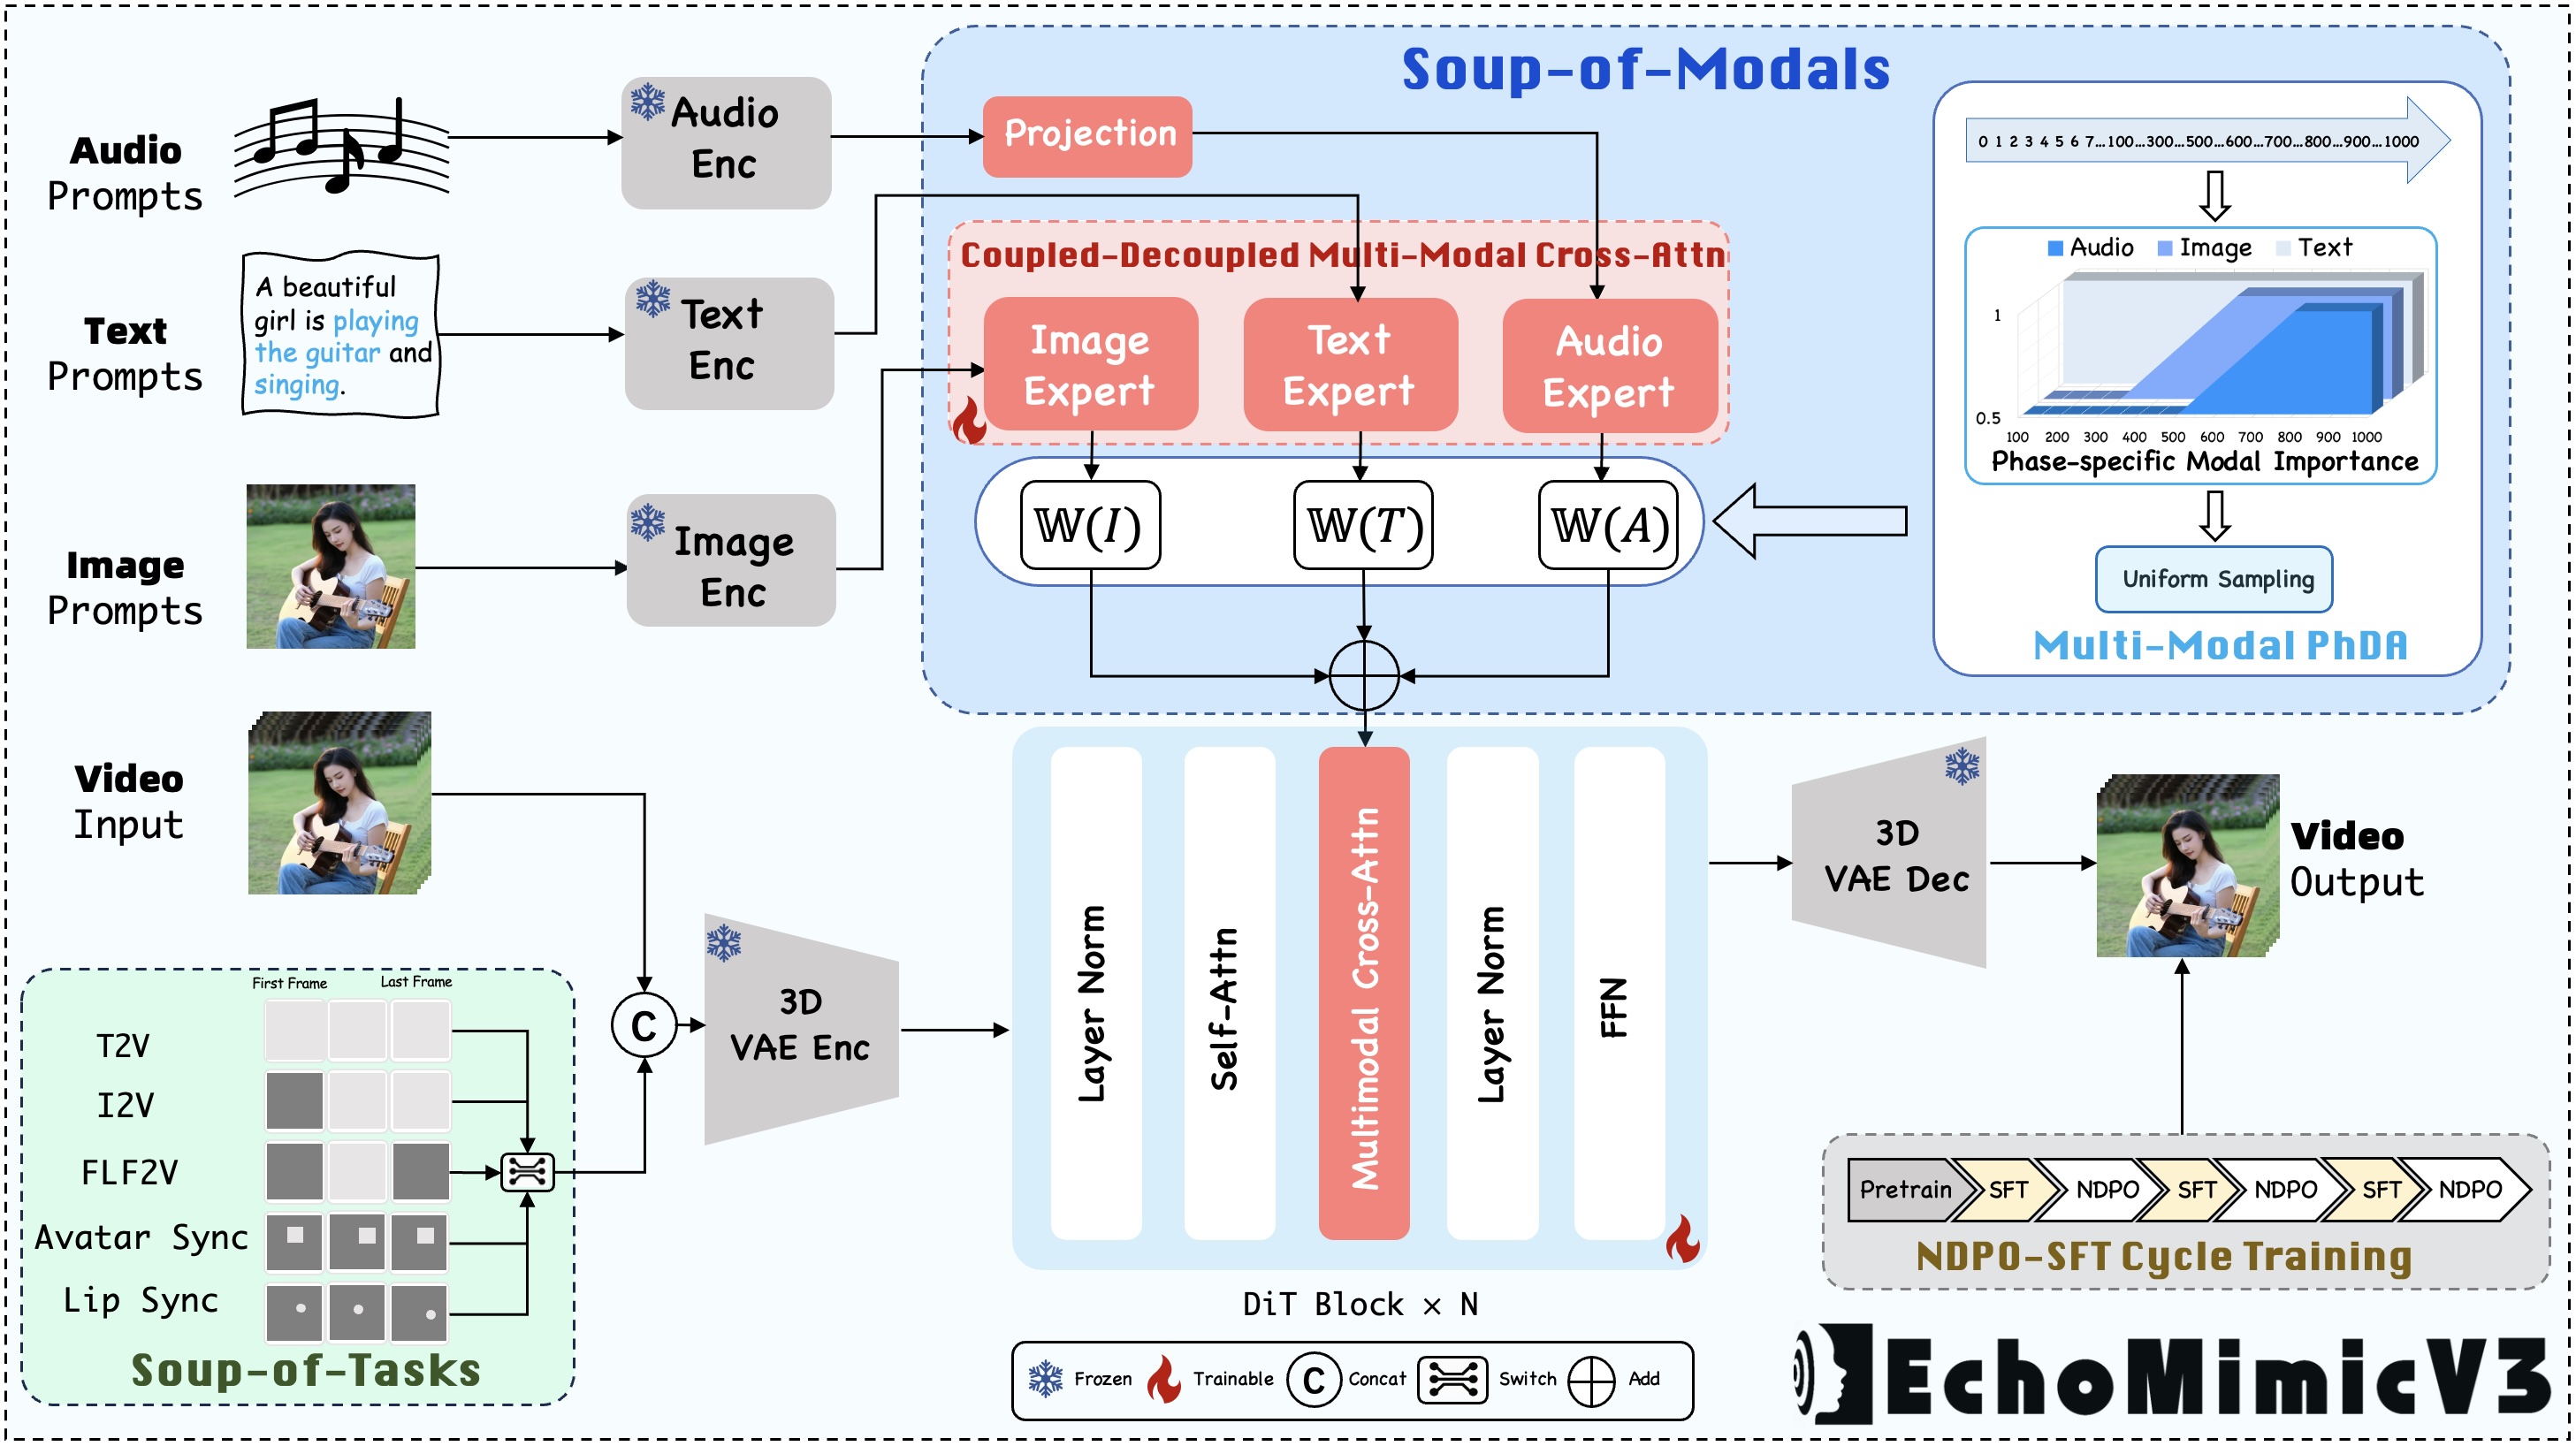
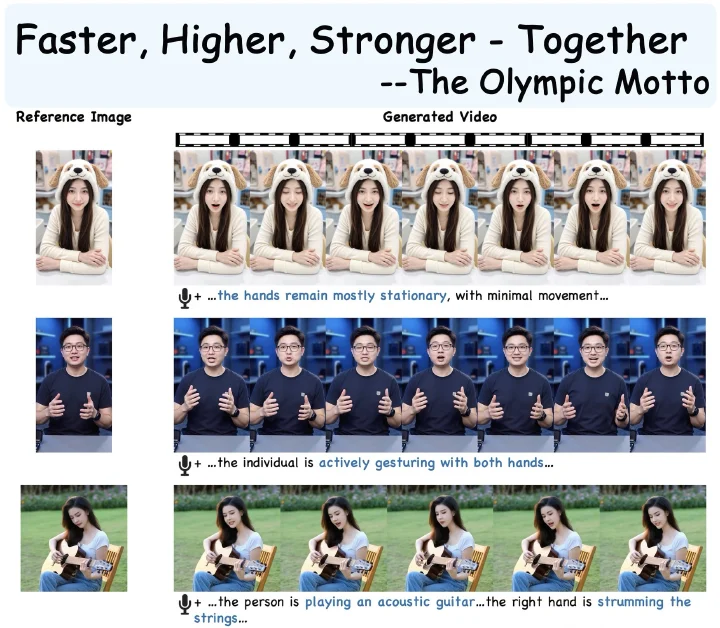
用户上传照片和文字/语音后,模型可生成口播、歌唱、卡通等风格的数字人动画,支持多任务统一(如音频驱动、文本驱动、视频驱动),并具备长视频推理能力。
一句话商业模式
为内容创作者、开发者、企业解决数字人视频生成门槛高、成本高、需要大量算力,通过EchoMimicV3 开源模型及配套工具提供价值,主要依靠目前完全免费开源,潜在收费方式包括云 API 或企业定制(假设)赚钱
商业模式画布
提供轻量级(1.3B)、低显存(12GB)、多场景(口播/歌唱/卡通)的数字人一键生成能力,完全开源免费
评分解析
研究分 67
这是什么
- 是什么
- 一个 1.3B 参数的开源数字人生成模型,能够根据单张照片和音频/文本输入生成逼真的数字人视频。
- 给谁用
- 面向内容创作者、AI 开发者、数字人应用企业、学术研究者,以及需要快速生成数字人视频的个人或团队。