Crawler.sh
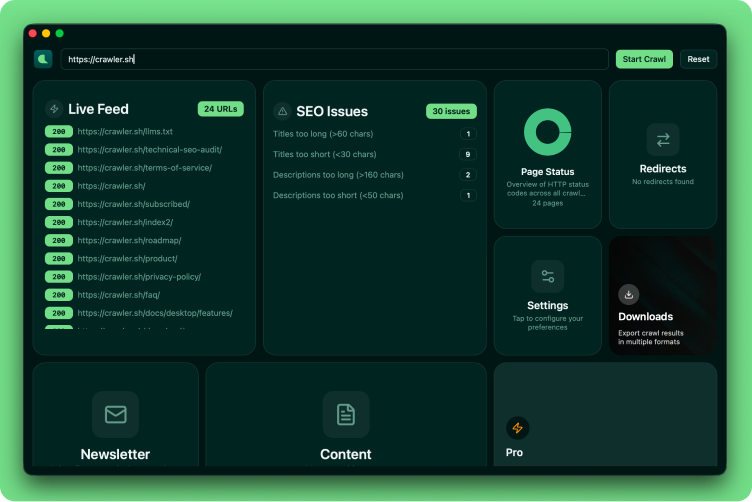
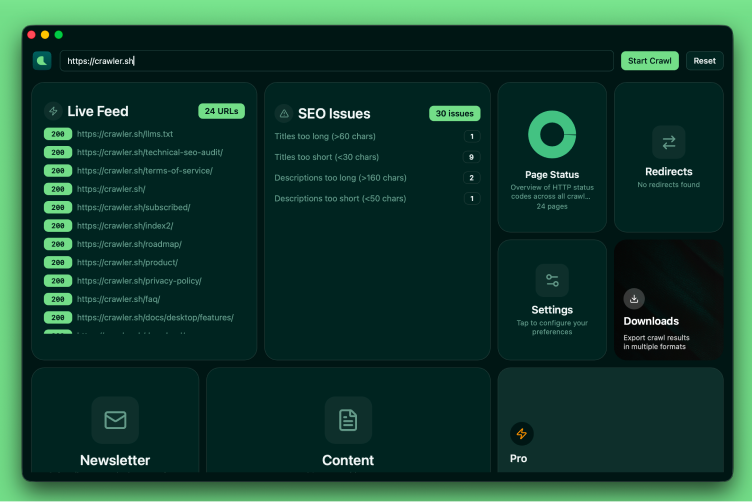
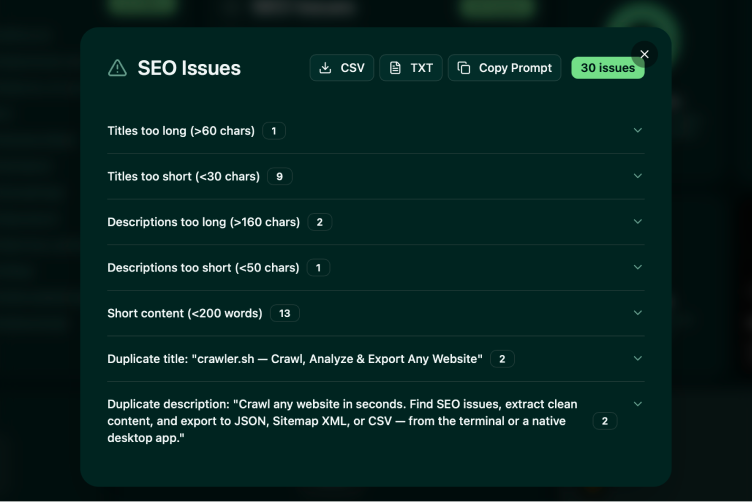
爬取网站并提取主要内容为 Markdown,支持 JavaScript 渲染(React/Vue/Next 等 SPA)、自动遵守 robots.txt、自适应爬取速率、24 项 SEO 自动检查、批量导出为 Markdown 存档、生成 Sitemap XML、监控网站变化。
一句话商业模式
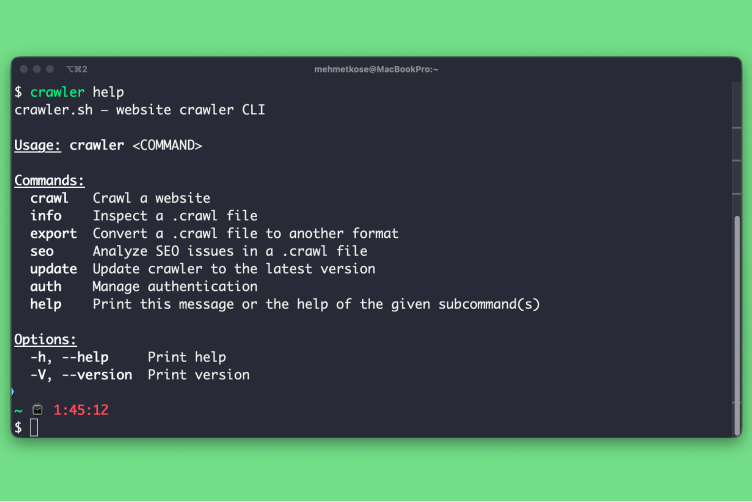
为AI 开发者、MLOps 团队、SEO 专家、内容归档者解决需要从网站提取干净、结构化的内容用于 AI 训练/RAG,或进行技术 SEO 审计,但现有方案(如 Headless Chrome、云 API)成本高、有配额限制、隐私风险大,通过本地运行的网页爬虫与 SEO 审计工具(CLI + 桌面应用),支持 Markdown 提取、JavaScript 渲染、SEO 检查、批量导出提供价值,主要依靠Pro 版年订阅(99 美元/年),覆盖 CLI 和桌面应用;免费版限制每会话 50 页以引导付费赚钱
商业模式画布
提供本地运行、隐私友好、无配额限制的网页爬虫,内置 JavaScript 渲染引擎,自动遵守 robots.txt,支持批量 Markdown 导出和 SEO 审计,一次付费覆盖 CLI 和桌面应用
评分解析
研究分 71
这是什么
- 是什么
- 一款本地运行的网页爬虫与 SEO 审计工具,能将网站内容提取为干净的 Markdown 格式,适用于 AI 训练、RAG 管道和 Agent 上下文。
- 给谁用
- AI 开发者(构建训练数据集)、MLOps 团队(数据管道)、SEO 专家(技术审计)、内容归档者(备份/迁移)。