BrowserAct

用户用自然语言描述所需数据,BrowserAct 自动构建、测试并运行可复用的爬虫,输出结构化数据(CSV/Markdown),并自动处理网站变化、验证码和反爬机制。

一句话商业模式

为开发者和数据团队解决从网站稳定获取结构化数据,需应对反爬、验证码和网站变化,通过AI 驱动的可复用爬虫平台(云端 + CLI)提供价值,主要依靠按量付费信用点 + 订阅计划(年付享 20% 折扣)赚钱

商业模式画布

用自然语言即可构建稳定、可复用的爬虫,自动处理反爬、验证码和网站变化,无需代码和维护

评分解析

研究分 77

这是什么

是什么
一个基于 AI Agent 的网页数据抓取平台,支持云端运行或本地 CLI 部署。
给谁用
面向需要从网站获取结构化数据的开发团队、数据研究员、电商运营、市场分析师和 AI Agent 开发者。
← 返回今日精选
BrowserAct

BrowserAct

用户用自然语言描述所需数据,BrowserAct 自动构建、测试并运行可复用的爬虫,输出结构化数据(CSV/Markdown),并自动处理网站变化、验证码和反爬机制。

77

一句话商业模式

为开发者和数据团队解决从网站稳定获取结构化数据,需应对反爬、验证码和网站变化,通过AI 驱动的可复用爬虫平台(云端 + CLI)提供价值,主要依靠按量付费信用点 + 订阅计划(年付享 20% 折扣)赚钱

开发者工具AI网页抓取数据采集浏览器自动化团队 未知(从官网和公开信息无法确定团队规模)发布 2025 年或更早(AppSumo 评价最早为 2026 年 2 月,产品已运营一段时间)最后同步 2026-07-27

产品图

商业模式画布

Business Model Canvas · 9 大模块完整填涂

重要合作Key Partnerships
AWS、Microsoft Azure、Google Cloud、Oracle、Alibaba Cloud、Huawei Cloud、BytePlus、Baidu AI Cloud
关键业务Key Activities
AI Agent 模型训练与优化、反检测技术研发、代理网络维护、文档与社区支持
价值主张Value Propositions
用自然语言即可构建稳定、可复用的爬虫,自动处理反爬、验证码和网站变化,无需代码和维护
客户关系Customer Relationships
自助服务(官网注册试用)、文档与教程、社区(AppSumo/X)、邮件支持
客户细分Customer Segments
开发团队、数据研究员、电商运营、市场分析师、AI Agent 开发者
核心资源Key Resources
AI 模型、代理网络、浏览器指纹库、验证码求解引擎、CLI 工具链
渠道通路Channels
通过 AppSumo、Product Hunt、G2 等平台获客,以及开发者社区(GitHub、X/Twitter)口碑传播
成本结构Cost Structure
云计算资源(代理、浏览器实例)、AI 模型推理成本、研发人力、市场推广费用
收入来源Revenue Streams
按量付费信用点(按使用量计费)+ 订阅计划(月付/年付),年付享 20% 折扣
💡 核心痛点:从网站抓取数据时面临反爬机制、验证码、网站结构变化、维护成本高、需要编写复杂代码⚠️ 最大风险:依赖第三方网站反爬策略变化,需持续更新反检测能力;面临同类工具(如 ScrapingBee、Octoparse)竞争

评分解析

痛点清晰度

材料清晰描述了从网站抓取数据时面临的反爬、验证码、维护成本高等痛点,且用户评价中反复提及这些痛点被解决。

置信度 90%
85
付费可能性

采用信用点按量付费模式,定价明确(如本地指纹浏览器 100 信用点/$0.064),且提供年付折扣,说明有清晰的变现路径。但无总收入数据,付费转化率未知。

置信度 80%
80
市场与趋势

网页数据抓取是持续需求,尤其 AI Agent 和自动化工作流兴起后需求增长。但竞争激烈,已有 ScrapingBee、Octoparse 等成熟工具。

置信度 70%
75
需求信号

AppSumo 评分 4.4 且有多条正面评价(如“节省数百小时”“首次尝试即成功”),G2 评分 4.6,说明用户认可度高。但无具体用户量数据。

置信度 70%
70
执行可行性

产品已上线运营,有完整官网、文档、定价和用户评价,说明团队具备交付能力。但团队规模未知,可能影响长期迭代速度。

置信度 80%
80
中国市场适配

产品支持中文自然语言描述,合作伙伴包括阿里云、华为云、字节跳动等中国云厂商,说明对中国市场有布局。但定价以美元计,且代理网络可能受中国网络限制影响。

置信度 60%
65

这是什么

是什么
一个基于 AI Agent 的网页数据抓取平台,支持云端运行或本地 CLI 部署。
给谁用
面向需要从网站获取结构化数据的开发团队、数据研究员、电商运营、市场分析师和 AI Agent 开发者。
关键能力

  • 自然语言驱动:用一句话描述数据需求,无需编写代码或选择器
  • 内置反检测与验证码破解:使用真实浏览器指纹、动态代理和智能验证码求解(成功率 99%+)
  • 会话隔离与并发:支持多任务、多账户、多会话独立运行,互不干扰
  • 云端与本地双模式:可在 BrowserAct Cloud 直接运行,也可通过 Agent CLI 集成到本地 AI Agent 环境
  • 可复用爬虫(Bot):一次构建,持续运行,自动适应网站结构变化
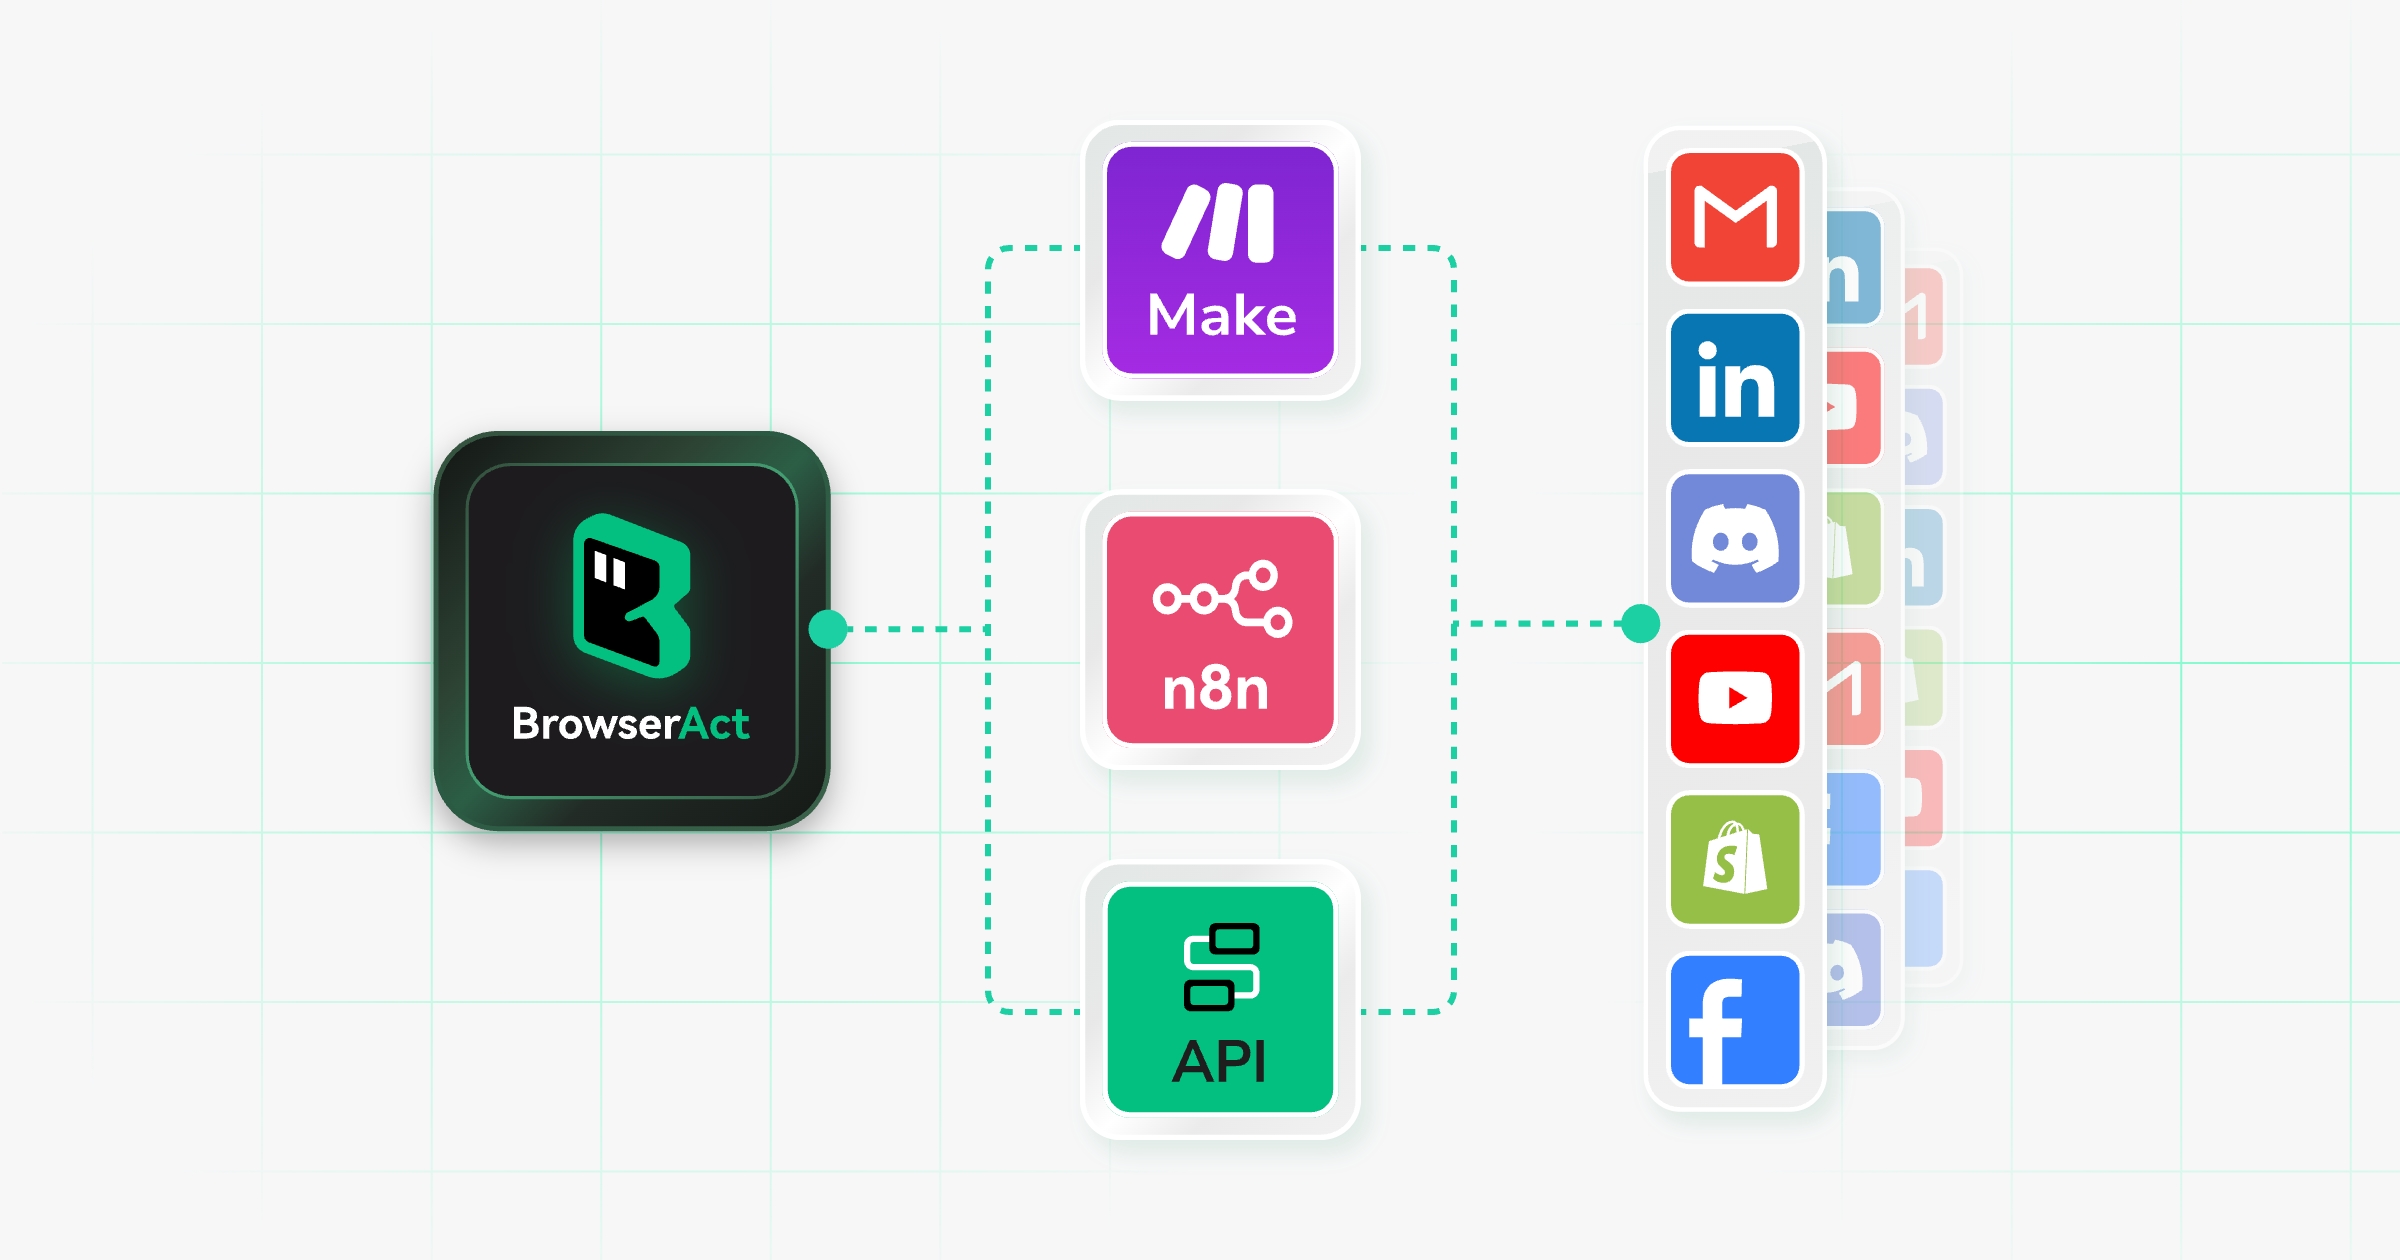
  • 集成生态:支持 Make、n8n、Zapier 等自动化平台,输出 CSV/Markdown 等格式

创业线索

团队
未知(从官网和公开信息无法确定团队规模) · 独立开发者或小团队可能性较高,但无明确证据
发布时间
2025 年或更早(AppSumo 评价最早为 2026 年 2 月,产品已运营一段时间) · 官网和文档持续更新,2026 年仍有新评价和功能发布
增长线索
AppSumo 评分 4.4(多用户好评),G2 评分 4.6,GitHub 存在但星标数未在材料中明确
能赚多少 / 怎么赚
定价页显示信用点单价(如本地指纹浏览器 100 信用点/$0.064),但无总收入数据 · 明确采用信用点付费模式,提供 7 天免费试用,年付享 20% 折扣
  • since I discovered BrowserAct 😅 It&

公开信息推断,缺数据会标未知;不构成收益承诺。

来源数据

  • 首次采集:2026-07-26
  • 最后同步:2026-07-27
  • 材料更新:2026-07-27
  • 穿透材料体量:约 20,844 字

AI 辅助分析,仅供项目研究参考,不构成投资建议。